Khi sử dụng SMARTPLS 4 để phân tích mô hình PLS-SEM, một trong những vấn đề chúng ta cần quan tâm là sai lệch phương pháp chung (Common Method Bias – CMB). Vấn đề này thường được xem xét trong các nghiên cứu sử dụng dữ liệu khảo sát, đặc biệt khi các biến độc lập và biến phụ thuộc được thu thập từ cùng một người trả lời.
Để kiểm tra CMB, chúng ta có thể sử dụng phương pháp Full Collinearity VIF được Kock (2015) đề xuất. Phương pháp này dựa trên hệ số VIF của các biến tiềm ẩn để đánh giá hiện tượng cộng tuyến toàn phần, từ đó xem xét nguy cơ sai lệch phương pháp chung trong mô hình nghiên cứu.
Trong bài viết này, chúng ta sẽ tìm hiểu cách kiểm tra CMB bằng Full Collinearity VIF trong SMARTPLS 4, bao gồm tiêu chuẩn đánh giá, cách lấy dữ liệu, thực hiện kiểm tra và viết nhận xét kết quả trong luận văn.
1. CMB và Full Collinearity VIF là gì?
a. Hiện tượng Common Method Bias – CMB
Common Method Bias (CMB) là sai lệch có thể xuất hiện khi phương pháp thu thập hoặc đo lường dữ liệu ảnh hưởng đến mối quan hệ giữa các biến nghiên cứu. Khi xảy ra CMB, một phần tương quan giữa các biến có thể đến từ phương pháp đo lường thay vì phản ánh hoàn toàn mối quan hệ thực tế giữa các khái niệm.
Ví dụ, một nghiên cứu sử dụng bảng hỏi để đo lường sự hài lòng, niềm tin và ý định tiếp tục sử dụng dịch vụ. Nếu người tham gia có xu hướng lựa chọn mức đồng ý cao cho hầu hết câu hỏi, tương quan giữa các nhân tố có thể bị ảnh hưởng bởi cách trả lời. Đây là một tình huống có thể làm phát sinh sai lệch phương pháp chung, dù không phải mọi nghiên cứu sử dụng cùng một bảng hỏi đều gặp vấn đề này.
Trong nghiên cứu định lượng, CMB thường được nhắc đến cùng với Common Method Variance (CMV). Hai thuật ngữ có liên quan nhưng không hoàn toàn giống nhau. CMV đề cập đến phần phương sai gắn với phương pháp đo lường, còn CMB là sai lệch mà yếu tố phương pháp có thể gây ra đối với kết quả phân tích.
b. Full Collinearity VIF là gì?
Full Collinearity VIF là hệ số được sử dụng để đánh giá mức độ cộng tuyến của từng biến tiềm ẩn với tất cả các biến tiềm ẩn còn lại trong mô hình. Phương pháp này được Kock (2015) đề xuất để kiểm tra CMB trong phân tích PLS-SEM.
Để hiểu đơn giản, giả sử mô hình nghiên cứu có bốn nhân tố gồm sự hài lòng (SAT), niềm tin (TRU), hữu ích cảm nhận (PU) và ý định tiếp tục sử dụng (CI). Khi kiểm tra Full Collinearity VIF, chúng ta cần xác định mức độ cộng tuyến của từng nhân tố với ba nhân tố còn lại, thay vì chỉ kiểm tra các biến độc lập có tác động trực tiếp đến CI.
Hệ số VIF được tính theo công thức:
VIF = 1 / (1 − R²)
Trong đó, R² là hệ số xác định khi một biến được hồi quy theo các biến dự báo còn lại. Giá trị VIF càng lớn cho thấy mức độ cộng tuyến càng cao.
Ở đây chúng ta cần phân biệt Full Collinearity VIF với Inner VIF thông thường trong SMARTPLS. Inner VIF của mô hình cấu trúc được sử dụng để kiểm tra cộng tuyến giữa các biến độc lập cùng tác động đến một biến phụ thuộc. Trong khi đó, Full Collinearity VIF xem xét cộng tuyến giữa tất cả các biến tiềm ẩn thuộc mô hình nghiên cứu.
Vì vậy, nếu chỉ lấy bảng Inner VIF từ mô hình ban đầu để đánh giá CMB thì chưa đúng với cách kiểm tra Full Collinearity được trình bày trong bài viết này.
2. Ngưỡng đánh giá CMB bằng Full VIF theo Kock (2015)
Theo Kock (2015), phương pháp Full Collinearity Assessment có thể sử dụng ngưỡng VIF bằng 3.3 để đánh giá nguy cơ sai lệch phương pháp chung trong mô hình PLS-SEM.
Chúng ta sẽ đánh giá kết quả theo hai trường hợp:
-
Full Collinearity VIF ≤ 3.3: Đáp ứng tiêu chuẩn đánh giá CMB được Kock (2015) đề xuất.
-
Full Collinearity VIF > 3.3: Cho thấy dấu hiệu cộng tuyến cao, đồng thời đặt ra khả năng mô hình chịu ảnh hưởng của CMB và cần được xem xét thêm.
Để mô hình đáp ứng tiêu chuẩn này, tất cả các biến tiềm ẩn được đưa vào kiểm tra cần có Full Collinearity VIF không vượt quá 3.3. Chỉ cần một biến có VIF lớn hơn ngưỡng thì kết quả chưa đáp ứng đầy đủ tiêu chuẩn đánh giá đang sử dụng.
Trong nghiên cứu của Kock (2015), tác giả đề xuất sử dụng Full Collinearity Assessment để nhận diện nguy cơ CMB dựa trên mức độ cộng tuyến giữa các biến tiềm ẩn. Đây là cách tiếp cận khác với việc chỉ kiểm tra cộng tuyến giữa những biến độc lập trong mô hình cấu trúc.
Một điểm cần chú ý là ngưỡng 3.3 không phải tiêu chuẩn VIF duy nhất trong PLS-SEM. Khi đánh giá cộng tuyến của mô hình cấu trúc, chúng ta có thể gặp các ngưỡng khác tùy theo tài liệu và mục tiêu phân tích. Kock (2015) cũng thảo luận ngưỡng 5 trong bối cảnh một số thuật toán ước lượng có xét đến sai số đo lường.
Trong bài viết này, chúng ta sử dụng ngưỡng Full Collinearity VIF ≤ 3.3 theo cách tiếp cận của Kock (2015) đối với PLS-SEM thông thường.
Nếu tất cả VIF đều đáp ứng ngưỡng, chúng ta có thể kết luận rằng mô hình không ghi nhận dấu hiệu CMB đáng kể theo phương pháp kiểm tra này. Kết quả đó không đồng nghĩa với việc đã chứng minh dữ liệu hoàn toàn không có sai lệch phương pháp chung, bởi CMB còn liên quan đến thiết kế bảng hỏi và cách thu thập dữ liệu.
3. Hướng dẫn kiểm tra Full Collinearity VIF trong SMARTPLS 4
Khi xử lý dữ liệu bằng SMARTPLS, trước khi đi sâu vào các bước phân tích chính, chúng ta nên kiểm tra CMB trước. Hiểu đơn giản, bước này giúp xem dữ liệu khảo sát có xuất hiện dấu hiệu sai lệch do các biến được thu thập bằng cùng một phương pháp hay không.
Nếu kết quả kiểm tra CMB đạt yêu cầu, chúng ta có thể tiếp tục các bước tiếp theo như đánh giá mô hình đo lường, mô hình cấu trúc, kiểm định giả thuyết và các phân tích chuyên sâu khác trong SMARTPLS.
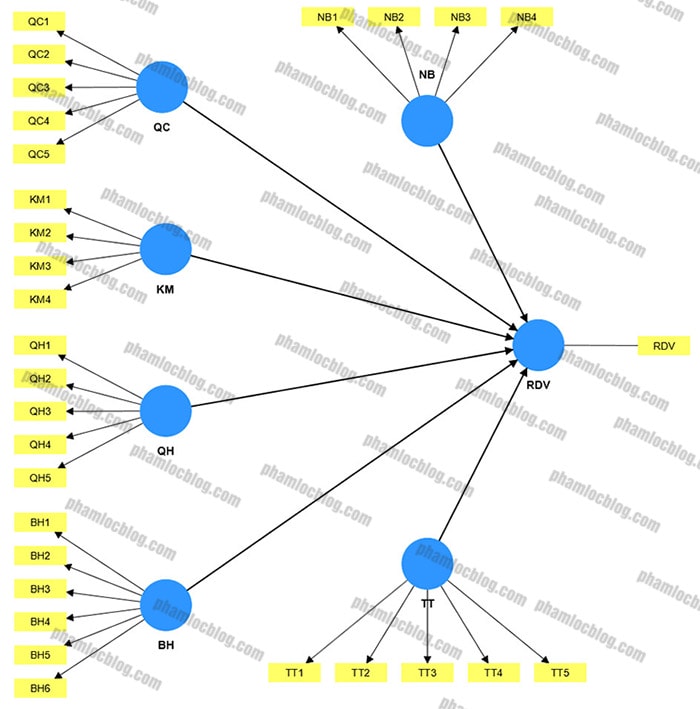
Để thuận tiện cho phần hướng dẫn, mình sẽ lấy một ví dụ thực hành là mô hình nghiên cứu như ảnh bên dưới.
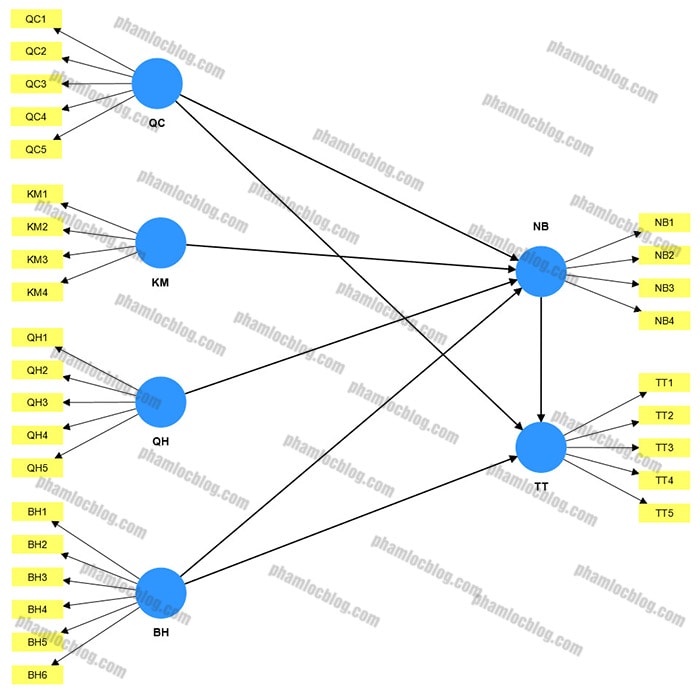
Bước 1: Tạo Random Dependent Variable (RDV)
Trước tiên, mở file Excel/CSV chứa dữ liệu đầu vào đang sử dụng cho phân tích bài trên SMARTPLS. Tạo thêm một cột mới ở cuối dữ liệu và đặt tên: RDV. Tại ô đầu tiên của cột RDV, nhập công thức: =RAND()
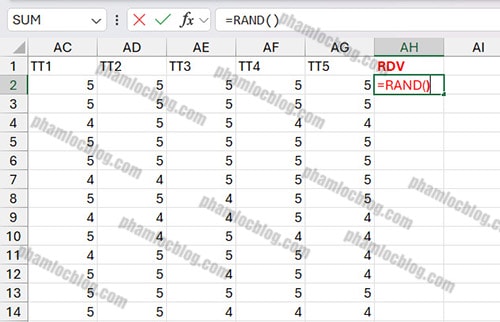
Sau đó áp dụng công thức cho toàn bộ số quan sát trong bộ dữ liệu. Hàm RAND() tạo các giá trị ngẫu nhiên liên tục trong khoảng từ 0 đến 1. Đây cũng là cách tạo RDV được Kazykhankyzy và cộng sự (2026) sử dụng trong quy trình đánh giá CMB trên SMARTPLS. Sau khi tạo xong, RDV sẽ có một giá trị tương ứng với mỗi quan sát trong dữ liệu.
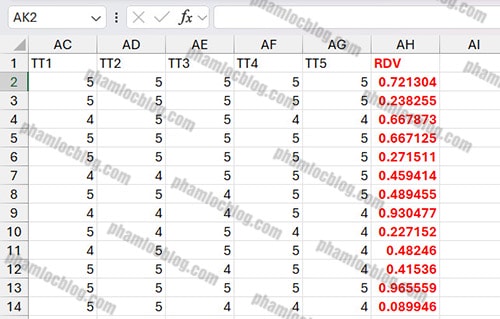
Vì hàm RAND() thuộc nhóm hàm động của Excel, các giá trị ở cột RDV sẽ bị thay đổi nhảy ngẫu nhiên chứ không cố định sau khi tạo. Vì vậy, sau khi tạo xong dữ liệu cho cột RDV, chúng ta cần bôi chọn toàn bộ cột RDV (kể cả tên cột RDV), sao chép dữ liệu bằng Ctrl + C hoặc nhấp phải chuột vào vùng được chọn bấm phải chuột, chọn Copy.
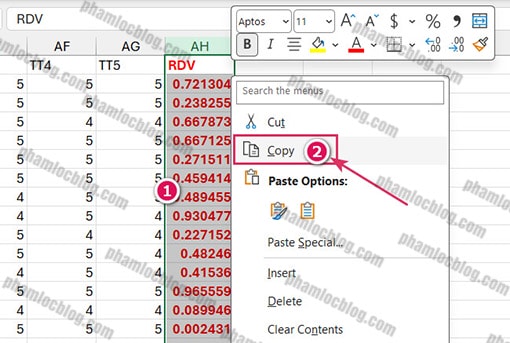
Sau đó nhấn phải chuột tại chính ô tên biến “RDV”, chọn mục Paste Special.
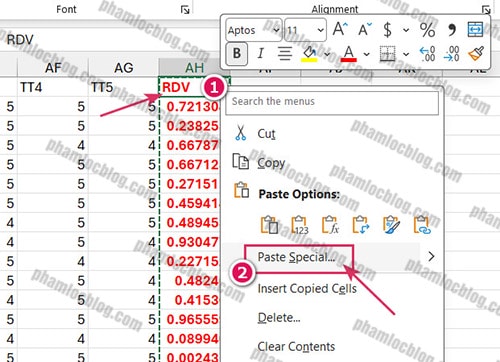
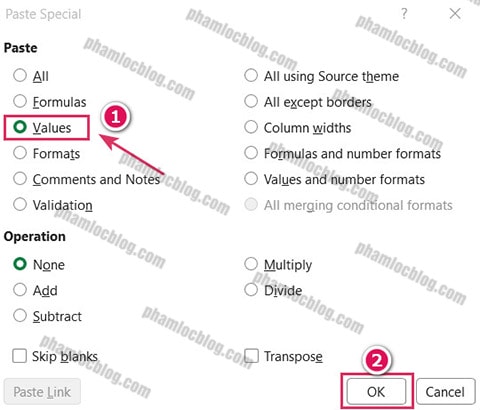
Tích vào mục “Values” và bấm OK để hoàn thành. Thao tác này giúp đưa giá trị cột RDV từ giá trị động thành giá trị cố định để đưa vào SMARTPLS.
Bước 2: Đưa RDV vào dữ liệu SMARTPLS
Sau khi bổ sung RDV, lưu lại file dữ liệu. Mở project SMARTPLS bài làm, xóa file dữ liệu cũ và import file dữ liệu mới có RDV vào. Lúc này, bên cạnh các biến quan sát ban đầu sẽ xuất hiện thêm biến RDV.
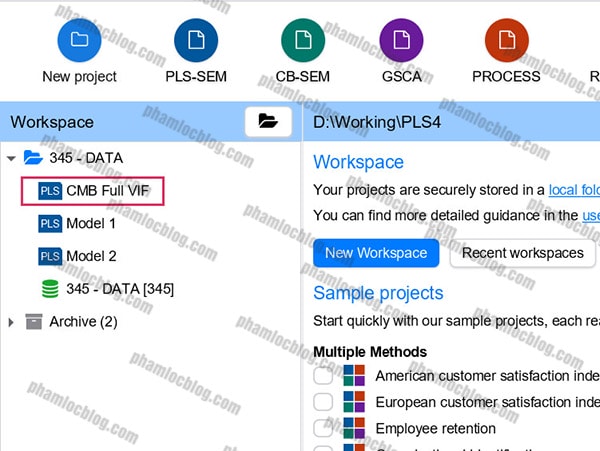
Tạo một diagram mới đặt tên là “CMB Full VIF” chẳng hạn dùng để phục vụ bước vẽ mô hình đánh giá Full VIF.
Bước 3: Tạo mô hình Full Collinearity VIF
Sau khi có RDV, bước tiếp theo là đưa toàn bộ biến tiềm ẩn cần kiểm tra CMB vào dự báo RDV. Tiến hành biểu diễn toàn bộ các cấu trúc biến của dữ liệu vào diagram. Nếu mô hình nghiên cứu lý thuyết có các biến bậc hai, chúng ta chỉ biểu diễn các cấu trúc biến bậc một thôi.
Tạo một construct mới trong model và đặt tên RDV, sau đó kéo biến RDV vừa bổ sung vào làm chỉ báo cho construct này, RDV chỉ có một biến quan sát. Ở đây không cần xây dựng thêm thang đo cho RDV. Biến này không đại diện cho một khái niệm lý thuyết của nghiên cứu mà được tạo ra để phục vụ cho việc thiết lập mô hình Full Collinearity VIF.
Vẽ mũi tên tác động từ toàn bộ các biến tiềm ẩn của bài hướng vào biến phụ thuộc RDV, chúng ta có được diagram như ảnh bên dưới.
Bước 4: Chạy PLS-SEM Algorithm
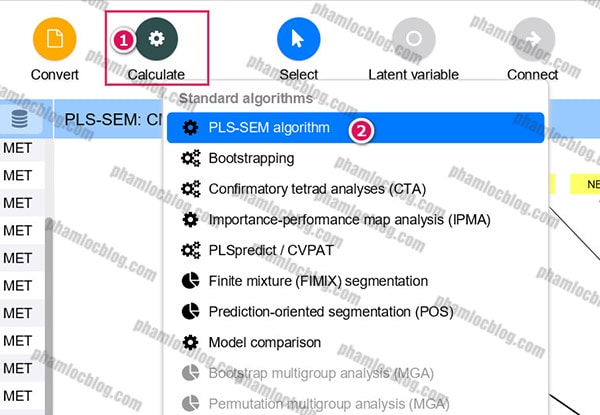
Sau khi hoàn thành các đường dẫn đến RDV, chọn vào biểu tượng Calculate, nhấp vào mục PLS-SEM algorithm để phân tích ước lượng.
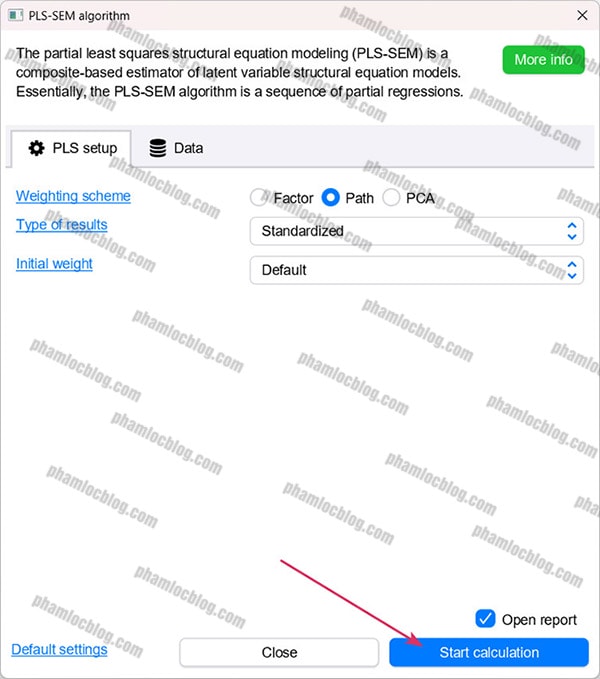
Ở cửa sổ thiết lập, bạn giữ mặc định và bấm và Start Calculation.
Bước 5: Lấy kết quả Full Collinearity VIF
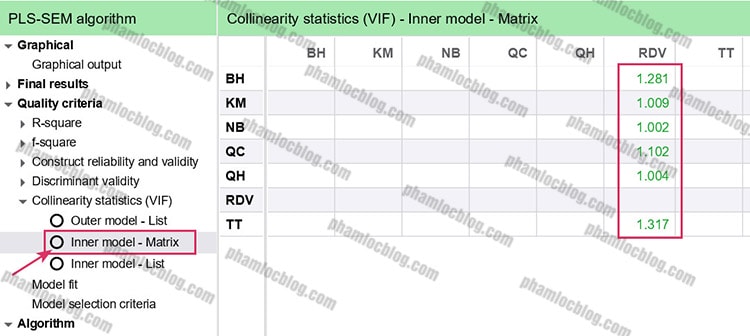
Trong cửa sổ kết quả SMARTPLS, truy cập phần Quality Criteria → Collinearity Statistics (VIF) → Inner model – Matrix.
Tại bảng Inner VIF, tìm cột RDV. Các giá trị VIF của từng biến tiềm ẩn tại cột RDV là kết quả chúng ta cần lấy để đánh giá Full Collinearity VIF.
4. Cách đọc kết quả Full Collinearity VIF
Khi đã có bảng Full Collinearity VIF, chúng ta sẽ đối chiếu giá trị VIF của từng biến tiềm ẩn với ngưỡng 3.3 theo Kock (2015).
Có thể lập bảng tổng hợp theo mẫu sau:
| Nhân tố | Full Collinearity VIF |
|---|---|
| BH | 1.281 |
| KM | 1.009 |
| NB | 1.002 |
| QC | 1.102 |
| QH | 1.004 |
| TT | 1.317 |
Nếu tất cả các biến đều có VIF không vượt quá 3.3, mô hình đáp ứng tiêu chuẩn kiểm tra CMB đang áp dụng. Chúng ta có thể sử dụng kết quả này để nhận xét rằng không ghi nhận dấu hiệu sai lệch phương pháp chung đáng kể theo phương pháp Full Collinearity VIF.
Trường hợp có một hoặc nhiều biến có VIF lớn hơn 3.3, chúng ta cần xem lại mức độ tương quan giữa các biến tiềm ẩn. VIF cao cho thấy một biến có thể được giải thích khá nhiều bởi các biến còn lại, nhưng chưa đủ để khẳng định nguyên nhân chắc chắn là CMB.
Ở trường hợp này, bạn nên kiểm tra thêm nội dung các thang đo và kết quả giá trị phân biệt, đặc biệt là HTMT. Nếu các nhân tố có nội dung đo lường quá tương đồng, mức độ cộng tuyến cao có thể xuất phát từ chính cách xây dựng các khái niệm nghiên cứu.
Không nên loại biến quan sát hoặc loại cả nhân tố chỉ để đưa Full VIF xuống dưới 3.3. Việc điều chỉnh thang đo cần dựa trên cơ sở lý thuyết, nội dung câu hỏi và kết quả đánh giá mô hình đo lường.
Một trường hợp khác là Inner VIF trong mô hình cấu trúc ban đầu đều thấp nhưng Full Collinearity VIF lại cao hơn. Điều này có thể xảy ra vì hai phép kiểm tra sử dụng các tập biến dự báo khác nhau. Khi đánh giá CMB, chúng ta cần sử dụng kết quả từ mô hình phụ trợ đã xây dựng.
5. Cách viết nhận xét CMB trong luận văn
Sau khi hoàn thành kiểm tra, chúng ta có thể trình bày kết quả CMB trong phần đánh giá dữ liệu hoặc phần kết quả phân tích mô hình, tùy theo cấu trúc luận văn.
Nội dung nhận xét nên có phương pháp kiểm tra, nguồn tiêu chuẩn, khoảng giá trị VIF và kết luận. Không cần mô tả lại toàn bộ các thao tác trên phần mềm nếu đã trình bày bảng kết quả.
Trường hợp tất cả Full Collinearity VIF ≤ 3.3
Bạn có thể tham khảo cách nhận xét sau:
Kết quả kiểm tra sai lệch phương pháp chung (Common Method Bias – CMB) bằng phương pháp Full Collinearity VIF cho thấy các giá trị VIF của các biến tiềm ẩn dao động từ [giá trị nhỏ nhất] đến [giá trị lớn nhất], đều không vượt quá ngưỡng 3.3 theo Kock (2015). Như vậy, mô hình nghiên cứu đáp ứng tiêu chuẩn đánh giá CMB bằng Full Collinearity VIF, cho thấy không ghi nhận dấu hiệu sai lệch phương pháp chung đáng kể theo phương pháp kiểm tra này.
Trường hợp có Full Collinearity VIF > 3.3
Nếu một số biến có VIF vượt ngưỡng, chúng ta cần trình bày đúng kết quả thay vì kết luận dữ liệu không có CMB.
Kết quả kiểm tra sai lệch phương pháp chung bằng phương pháp Full Collinearity VIF cho thấy một số biến tiềm ẩn có giá trị VIF vượt ngưỡng 3.3 theo Kock (2015). Kết quả này cho thấy mô hình chưa đáp ứng đầy đủ tiêu chuẩn đánh giá CMB được áp dụng, đồng thời ghi nhận hiện tượng cộng tuyến cao giữa một số biến tiềm ẩn. Do đó, cần xem xét thêm đặc điểm thang đo và phương pháp thu thập dữ liệu để đánh giá khả năng ảnh hưởng của sai lệch phương pháp chung.
Các giá trị trong ngoặc vuông cần được thay bằng kết quả thực tế. Nếu luận văn có nhiều nhân tố, bạn nên trình bày bảng tổng hợp VIF trước phần nhận xét để người đọc dễ đối chiếu.
6. Một số vấn đề thường gặp khi kiểm tra CMB trong SMARTPLS
Có thể lấy Inner VIF trong mô hình ban đầu để đánh giá CMB không?
Không nên lấy trực tiếp Inner VIF của mô hình ban đầu để thay thế Full Collinearity VIF. Trong mô hình cấu trúc, Inner VIF được tính cho từng nhóm biến độc lập cùng tác động đến một biến phụ thuộc, nên chưa phản ánh mức độ cộng tuyến giữa toàn bộ các biến tiềm ẩn.
Để kiểm tra theo hướng dẫn này, chúng ta cần sử dụng mô hình phụ trợ với tất cả các biến tiềm ẩn cùng tác động đến RDV.
Biến RDV có cần đạt ý nghĩa thống kê không?
Không cần. RDV chỉ là biến phụ trợ để SMARTPLS tính VIF, vì vậy chúng ta không cần kiểm tra ý nghĩa thống kê của các đường tác động đến RDV.
Tương tự, R² của RDV cũng không được sử dụng để đánh giá CMB. Khi xem kết quả mô hình phụ trợ, chúng ta chỉ quan tâm đến bảng VIF của các biến tiềm ẩn.
Có cần chạy Bootstrap để kiểm tra Full Collinearity VIF không?
Không cần chạy Bootstrap chỉ để lấy kết quả Full Collinearity VIF. Chúng ta sử dụng PLS-SEM Algorithm để tính VIF từ các điểm số biến tiềm ẩn.
Bootstrap được sử dụng khi cần kiểm định ý nghĩa thống kê của các hệ số hoặc ước lượng khoảng tin cậy. Trong quy trình kiểm tra Full VIF này, mục tiêu là đánh giá cộng tuyến nên không cần thực hiện bước đó.
Nếu Full Collinearity VIF lớn hơn 3.3 thì có cần loại biến không?
Không nên loại biến ngay khi thấy VIF vượt ngưỡng. Trước tiên, chúng ta cần xem lại các biến tiềm ẩn có tương quan cao với nhau hay không, đồng thời kiểm tra nội dung thang đo và kết quả giá trị phân biệt.
Nếu các nhân tố được xây dựng đúng theo lý thuyết và có mối liên hệ thực sự chặt chẽ, VIF cao chưa đủ để kết luận dữ liệu chắc chắn bị CMB. Trường hợp này cần được giải thích dựa trên đặc điểm nghiên cứu và các kết quả kiểm tra bổ sung.
Full Collinearity VIF có thay thế hoàn toàn các phương pháp kiểm tra CMB khác không?
Full Collinearity VIF là một phương pháp đánh giá nguy cơ CMB trong PLS-SEM, nhưng không có nghĩa chỉ cần VIF đạt ngưỡng là có thể loại trừ hoàn toàn sai lệch phương pháp chung.
Ngoài kiểm tra thống kê, người nghiên cứu còn cần quan tâm đến cách thiết kế và thu thập dữ liệu. Chẳng hạn, bảng hỏi nên hạn chế những câu có nội dung trùng lặp, tránh cách diễn đạt dẫn dắt và bảo đảm người tham gia có thể trả lời trung thực.
Trong một số nghiên cứu, chúng ta có thể kết hợp thêm những phương pháp kiểm tra CMB khác. Việc lựa chọn phương pháp nào phụ thuộc vào thiết kế nghiên cứu, loại dữ liệu và yêu cầu của luận văn.
7. Kết luận
Để kiểm tra CMB bằng Full Collinearity VIF trong SMARTPLS 4, chúng ta cần xuất Latent Variable Scores từ mô hình nghiên cứu, tạo biến phụ trợ RDV và xây dựng một mô hình mới với tất cả các biến tiềm ẩn cùng tác động đến RDV. Sau khi chạy PLS-SEM Algorithm, sử dụng bảng Inner VIF của mô hình phụ trợ để đánh giá theo ngưỡng 3.3 của Kock (2015).
Nếu tất cả các giá trị VIF đều không vượt quá 3.3, mô hình đáp ứng tiêu chuẩn kiểm tra CMB theo phương pháp này. Trường hợp có VIF vượt ngưỡng, chúng ta cần kiểm tra thêm tương quan giữa các nhân tố, giá trị phân biệt và đặc điểm thang đo trước khi đưa ra kết luận.
Nếu bạn đang gặp khó khăn trong đánh giá CMB trên SMARTPLS hay phải xử lý dữ liệu vì có giá trị Full VIF vượt ngưỡng 3.3, bạn có thể tham khảo dịch vụ xử lý SMARTPLS của Xử Lý Định Lượng nhé.
Tài liệu tham khảo
Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1–10. DOI: 10.4018/IJEC.2015100101.
Kazykhankyzy, L., Khalmatova, Z., Seitova, M., Kılıç, E., & Çelik, H. E. (2026). An extended technology acceptance model to explain higher education students’ behavioral intention to use ChatGPT: The case of Kazakhstan. European Journal of Education, 61(3), e70746. DOI: 10.1111/ejed.70746.