Trong các nghiên cứu sử dụng dữ liệu khảo sát, Common Method Bias (CMB) là một vấn đề cần được xem xét, nhất là khi nhiều thang đo được thu thập từ cùng một nhóm người trả lời, trong cùng một bảng hỏi và tại cùng một thời điểm. Với PLS-SEM, Kock (2015) đề xuất Full Collinearity Assessment như một phương pháp hỗ trợ đánh giá CMB thông qua hệ số VIF.
Khó khăn khi áp dụng phương pháp này trên SMARTPLS nằm ở chỗ phần mềm không cung cấp trực tiếp một chỉ số riêng mang tên Full Collinearity VIF giống như WarpPLS. Vì vậy, chúng ta cần thiết lập thêm một mô hình để đưa các biến tiềm ẩn vào cùng một phương trình dự báo, sau đó sử dụng kết quả VIF để đánh giá.
Bài viết sẽ tập trung vào cách thực hiện Full Collinearity VIF trong SMARTPLS, từ việc tạo Random Dependent Variable (RDV), thiết lập mô hình, chạy kết quả cho đến cách đọc và trình bày VIF theo tiêu chí của Kock (2015).
1. CMB và Full Collinearity VIF trong PLS-SEM
Common Method Bias có thể phát sinh khi một phần sự biến thiên chung giữa các biến đến từ phương pháp đo lường được sử dụng, thay vì hoàn toàn xuất phát từ những khái niệm mà nghiên cứu muốn đo lường.
Vấn đề này thường được quan tâm trong nghiên cứu khảo sát. Chẳng hạn, nhiều khái niệm khác nhau cùng được đo bằng thang Likert, thu thập từ một người trả lời và trong cùng một lần khảo sát. Khi đó, phương pháp thu thập chung có thể tạo ra một phần biến thiên chung giữa các thang đo.
Kock (2015) đề xuất sử dụng Full Collinearity Assessment để hỗ trợ nhận diện CMB trong PLS-SEM. Khác với VIF chỉ được xem xét giữa các biến dự báo trong một phương trình cấu trúc nhất định, Full Collinearity Assessment hướng đến việc xem xét cả vertical và lateral collinearity giữa các biến tiềm ẩn.
Ngưỡng thường được quan tâm trong phép kiểm tra này là: Full Collinearity VIF ≤ 3.3
Theo Kock (2015), sự xuất hiện của VIF lớn hơn 3.3 được đề xuất như một dấu hiệu của pathological collinearity và cũng có thể cho thấy mô hình bị ảnh hưởng bởi CMB. Nếu tất cả VIF thu được từ Full Collinearity Assessment đều không vượt quá 3.3, kết quả không cho thấy vấn đề CMB theo tiêu chí này.
Cần đặt ngưỡng 3.3 đúng trong bối cảnh Full Collinearity Assessment dùng để đánh giá CMB. Không nên nhầm tiêu chí này với các ngưỡng VIF được sử dụng cho những mục đích đánh giá cộng tuyến khác trong PLS-SEM.
2. Từ phương pháp của Kock (2015) đến cách thực hiện trên SMARTPLS
Phương pháp Full Collinearity Assessment của Kock (2015) được minh họa bằng WarpPLS. Phần mềm này có khả năng cung cấp Full Collinearity VIF cho các biến tiềm ẩn trong mô hình.
Trong nghiên cứu của Kock (2015), hai bộ dữ liệu mô phỏng Monte Carlo được sử dụng: một bộ không có CMB và một bộ được tạo thêm common method variance. Với dữ liệu không có CMB, Full Collinearity VIF của ba biến tiềm ẩn lần lượt là 1.541, 1.472 và 1.739. Khi CMB được đưa vào dữ liệu, các giá trị tăng lên 2.619, 2.347 và 3.720. Trong đó, VIF = 3.720 đã vượt ngưỡng 3.3.
SMARTPLS lại không có một chức năng riêng để chúng ta nhấn vào và nhận ngay bảng Full Collinearity VIF. Muốn áp dụng cách đánh giá này, cần tạo một cấu trúc để các biến tiềm ẩn cùng đóng vai trò dự báo trong một phương trình.
Một cách triển khai trên SMARTPLS là bổ sung Random Dependent Variable (RDV).
Cách làm này cũng xuất hiện trong nghiên cứu thực nghiệm của Kazykhankyzy và cộng sự (2026). Nhóm tác giả tạo RDV có giá trị liên tục và phân phối đều từ 0 đến 1 bằng hàm RAND() trong Excel. Sau đó, tám biến tiềm ẩn của mô hình được xác định là các biến ngoại sinh, còn RDV với một chỉ báo được sử dụng làm biến nội sinh. Kết quả VIF thu được nằm trong khoảng 1.043–1.451, đều không vượt quá 3.3.
Trên cơ sở đó, chúng ta có thể áp dụng cách thiết lập RDV để lấy Full Collinearity VIF trong SMARTPLS.
3. Hướng dẫn kiểm tra Full Collinearity VIF trong SMARTPLS
Khi xử lý dữ liệu bằng SMARTPLS, trước khi đi sâu vào các bước phân tích chính, chúng ta nên kiểm tra CMB trước. Hiểu đơn giản, bước này giúp xem dữ liệu khảo sát có xuất hiện dấu hiệu sai lệch do các biến được thu thập bằng cùng một phương pháp hay không.
Nếu kết quả kiểm tra CMB đạt yêu cầu, chúng ta có thể tiếp tục các bước tiếp theo như đánh giá mô hình đo lường, mô hình cấu trúc, kiểm định giả thuyết và các phân tích chuyên sâu khác trong SMARTPLS.
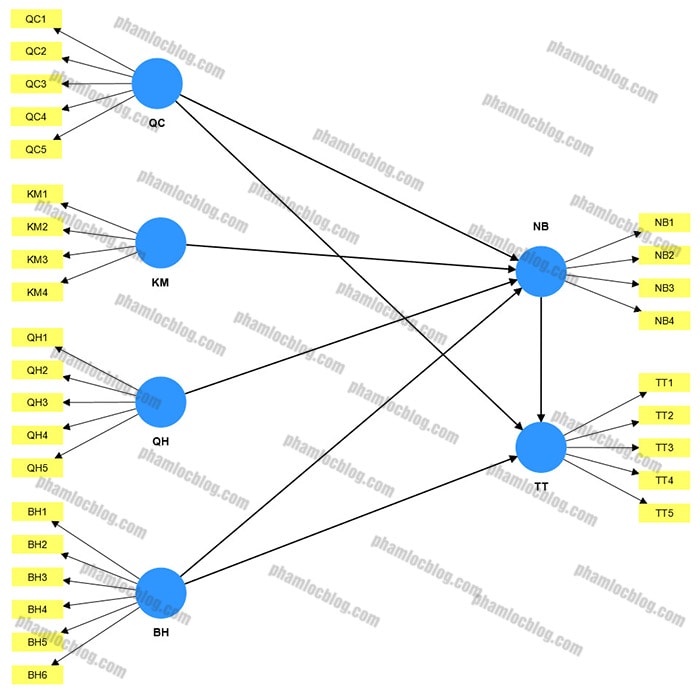
Để thuận tiện cho phần hướng dẫn, mình sẽ lấy một ví dụ thực hành là mô hình nghiên cứu như ảnh bên dưới.
Bước 1: Tạo Random Dependent Variable (RDV)
Trước tiên, mở file Excel/CSV chứa dữ liệu đầu vào đang sử dụng cho phân tích bài trên SMARTPLS. Tạo thêm một cột mới ở cuối dữ liệu và đặt tên: RDV. Tại ô đầu tiên của cột RDV, nhập công thức: =RAND()
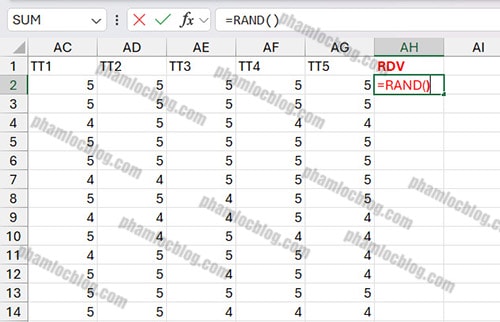
Sau đó áp dụng công thức cho toàn bộ số quan sát trong bộ dữ liệu. Hàm RAND() tạo các giá trị ngẫu nhiên liên tục trong khoảng từ 0 đến 1. Đây cũng là cách tạo RDV được Kazykhankyzy và cộng sự (2026) sử dụng trong quy trình đánh giá CMB trên SMARTPLS. Sau khi tạo xong, RDV sẽ có một giá trị tương ứng với mỗi quan sát trong dữ liệu.
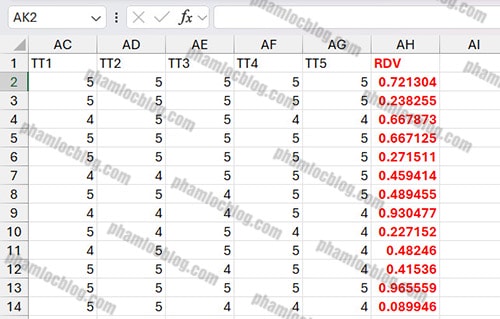
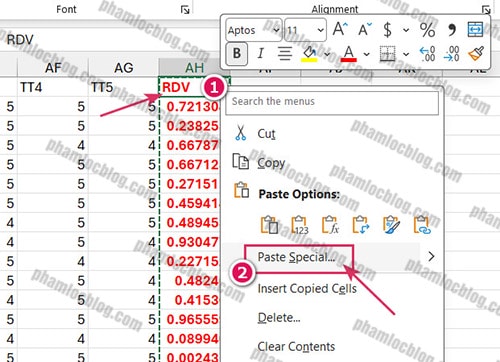
Vì hàm RAND() thuộc nhóm hàm động của Excel, các giá trị ở cột RDV sẽ bị thay đổi nhảy ngẫu nhiên chứ không cố định sau khi tạo. Vì vậy, sau khi tạo xong dữ liệu cho cột RDV, chúng ta cần bôi chọn toàn bộ cột RDV (kể cả tên cột RDV), sao chép dữ liệu bằng Ctrl + C hoặc nhấp phải chuột vào vùng được chọn bấm phải chuột, chọn Copy.
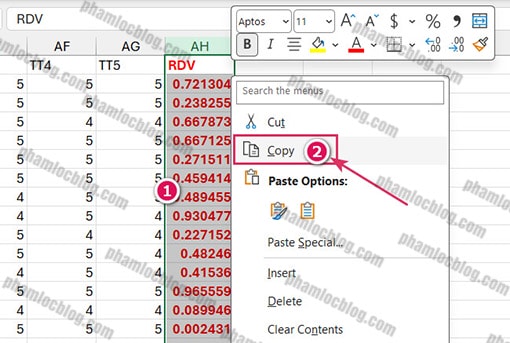
Sau đó nhấn phải chuột tại chính ô tên biến “RDV”, chọn mục Paste Special.
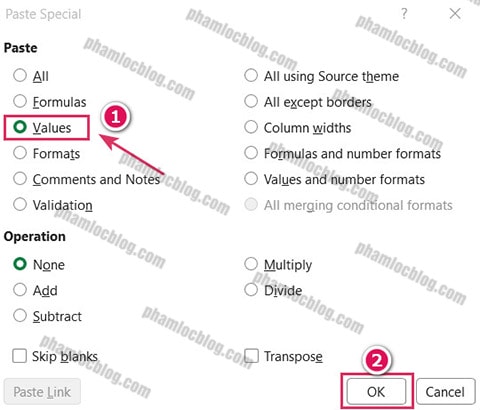
Tích vào mục “Values” và bấm OK để hoàn thành. Thao tác này giúp đưa giá trị cột RDV từ giá trị động thành giá trị cố định để đưa vào SMARTPLS.
Bước 2: Đưa RDV vào dữ liệu SMARTPLS
Sau khi bổ sung RDV, lưu lại file dữ liệu. Mở project SMARTPLS bài làm, xóa file dữ liệu cũ và import file dữ liệu mới có RDV vào. Lúc này, bên cạnh các biến quan sát ban đầu sẽ xuất hiện thêm biến RDV.
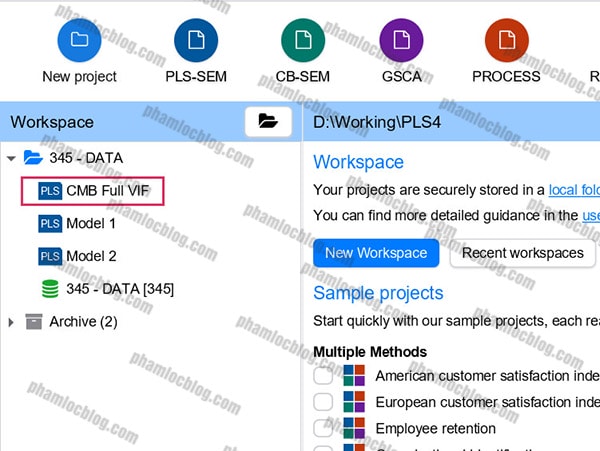
Tạo một diagram mới đặt tên là “CMB Full VIF” chẳng hạn dùng để phục vụ bước vẽ mô hình đánh giá Full VIF.
Bước 3: Tạo mô hình Full Collinearity VIF
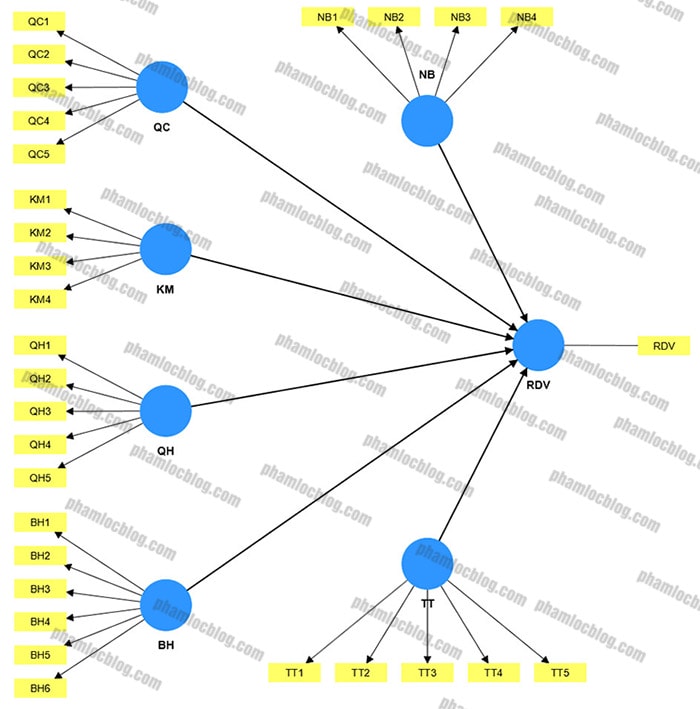
Sau khi có RDV, bước tiếp theo là đưa toàn bộ biến tiềm ẩn cần kiểm tra CMB vào dự báo RDV. Tiến hành biểu diễn toàn bộ các cấu trúc biến của dữ liệu vào diagram. Nếu mô hình nghiên cứu lý thuyết có các biến bậc hai, chúng ta chỉ biểu diễn các cấu trúc biến bậc một thôi.
Tạo một construct mới trong model và đặt tên RDV, sau đó kéo biến RDV vừa bổ sung vào làm chỉ báo cho construct này, RDV chỉ có một biến quan sát. Ở đây không cần xây dựng thêm thang đo cho RDV. Biến này không đại diện cho một khái niệm lý thuyết của nghiên cứu mà được tạo ra để phục vụ cho việc thiết lập mô hình Full Collinearity VIF.
Vẽ mũi tên tác động từ toàn bộ các biến tiềm ẩn của bài hướng vào biến phụ thuộc RDV, chúng ta có được diagram như ảnh bên dưới.
Bước 4: Chạy PLS-SEM Algorithm
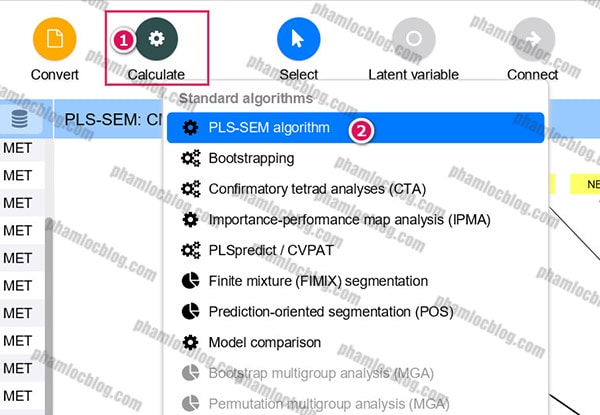
Sau khi hoàn thành các đường dẫn đến RDV, chọn vào biểu tượng Calculate, nhấp vào mục PLS-SEM algorithm để phân tích ước lượng.
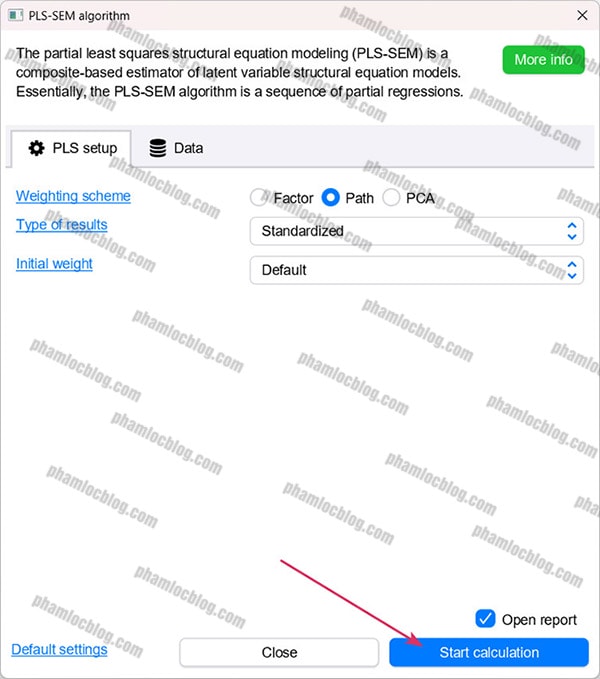
Ở cửa sổ thiết lập, bạn giữ mặc định và bấm và Start Calculation.
Bước 5: Lấy kết quả Full Collinearity VIF
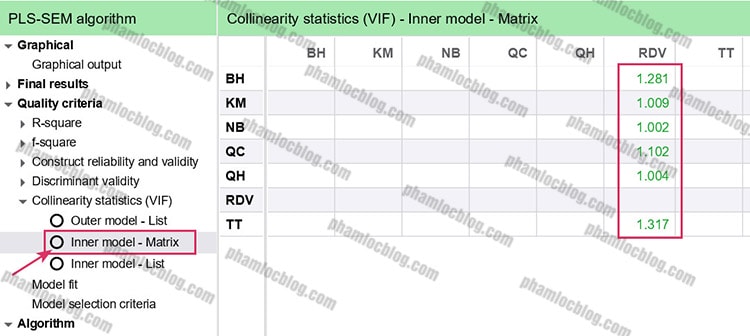
Trong cửa sổ kết quả SMARTPLS, truy cập phần Quality Criteria → Collinearity Statistics (VIF) → Inner model – Matrix.
Tại bảng Inner VIF, tìm cột RDV. Các giá trị VIF của từng biến tiềm ẩn tại cột RDV là kết quả chúng ta cần lấy để đánh giá Full Collinearity VIF.
4. Cách đọc và trình bày kết quả CMB
Sau khi lấy được VIF tại cột RDV, chúng ta không cần phân tích các hệ số đường dẫn đến RDV. Phần kết quả chủ yếu tập trung vào phạm vi VIF và so sánh với 3.3 theo nguồn của Kock (2015):
Nếu VIF ≤ 3.3: không cho thấy dấu hiệu CMB theo tiêu chí Full Collinearity Assessment.
Nếu VIF > 3.3: kết quả cho thấy dấu hiệu cần xem xét về CMB theo tiêu chí này.
Giả sử tất cả các biến tiềm ẩn trong mô hình đều có VIF nhỏ hơn 3.3, có thể nhận xét:
“Kết quả đánh giá Common Method Bias bằng Full Collinearity VIF cho thấy hệ số VIF của các biến tiềm ẩn đều nhỏ hơn 3.3. Theo tiêu chí Full Collinearity Assessment của Kock (2015), kết quả không cho thấy dấu hiệu Common Method Bias nghiêm trọng trong mô hình nghiên cứu.”
Nếu muốn trình bày đầy đủ hơn, nên báo cáo thêm VIF nhỏ nhất và VIF lớn nhất thay vì chỉ viết tất cả đều dưới ngưỡng.
Ví dụ:
“Kết quả Full Collinearity VIF của các biến tiềm ẩn dao động từ [VIF nhỏ nhất] đến [VIF lớn nhất], đều không vượt quá ngưỡng 3.3. Theo Kock (2015), kết quả không cho thấy dấu hiệu Common Method Bias nghiêm trọng trong mô hình.”
Cụ thể trong ví dụ mẫu thực hành bên trên, chúng ta có thể kết luận:
Kết quả Full Collinearity VIF cho thấy các giá trị VIF của BH, KM, NB, QC, QH và TT lần lượt là 1.281, 1.009, 1.002, 1.102, 1.004 và 1.317. Tất cả các giá trị đều nhỏ hơn ngưỡng 3.3 theo Kock (2015). Như vậy, kết quả không cho thấy dấu hiệu Common Method Bias (CMB) nghiêm trọng theo tiêu chí Full Collinearity VIF.
Cách diễn đạt này giữ kết luận trong đúng phạm vi của phép kiểm tra. Full Collinearity VIF là bằng chứng hỗ trợ đánh giá CMB; không nên từ một kết quả VIF dưới 3.3 mở rộng thành khẳng định tuyệt đối rằng dữ liệu hoàn toàn không thể tồn tại bất kỳ ảnh hưởng nào từ phương pháp đo lường.
5. Những điểm cần chú ý khi thực hiện Full Collinearity VIF
Một vấn đề dễ gặp khi làm trên SMARTPLS là nhầm giữa Inner VIF thông thường và Full Collinearity VIF.
Inner VIF trong mô hình nghiên cứu chính được tính theo các phương trình cấu trúc đã thiết lập. Full Collinearity Assessment lại cần đặt các construct cần đánh giá vào cấu trúc cho phép kiểm tra cộng tuyến đầy đủ hơn. Việc bổ sung RDV nhằm tạo ra chính điều kiện này.
Cũng không nên phân tích RDV giống một biến phụ thuộc thông thường. R² của RDV không phải kết quả dùng để kết luận CMB. Tương tự, Path Coefficients, t-value hay p-value của các đường dẫn đến RDV cũng không phải nội dung cần diễn giải.
Một điểm khác liên quan đến ngưỡng VIF. Trong SMARTPLS, chúng ta có thể gặp các ngưỡng VIF khác khi đánh giá mô hình đo lường hoặc mô hình cấu trúc. Tuy nhiên, nếu đang áp dụng Full Collinearity Assessment theo Kock (2015) để đánh giá CMB, tiêu chí đang được sử dụng là 3.3. Không nên đổi sang một ngưỡng khác chỉ vì kết quả hiện tại không đáp ứng 3.3. Kock (2015) đề xuất VIF trên 3.3 là dấu hiệu pathological collinearity và khả năng mô hình bị ảnh hưởng bởi CMB trong bối cảnh của phép kiểm tra này.
Nếu xuất hiện một hoặc nhiều Full Collinearity VIF vượt 3.3, cũng không nên lập tức loại biến quan sát để giảm VIF. Trước hết cần xem lại thiết kế bảng hỏi, nội dung các thang đo, cách thu thập dữ liệu và mức độ tương đồng giữa các construct. Việc xử lý CMB không giống với quy trình loại biến có outer loading thấp để cải thiện AVE.
6. Câu hỏi thường gặp
Câu hỏi 1: Full Collinearity VIF có bắt buộc trong mọi nghiên cứu SMARTPLS không?
Không có quy tắc cứng nhắc rằng tất cả nghiên cứu sử dụng SMARTPLS đều bắt buộc phải thực hiện Full Collinearity VIF. Việc đánh giá CMB cần căn cứ vào thiết kế nghiên cứu, phương pháp thu thập dữ liệu và yêu cầu của luận văn, luận án hoặc tạp chí.
Đối với nghiên cứu sử dụng bảng hỏi tự báo cáo và nhiều construct được thu thập từ cùng một người trả lời, CMB thường là vấn đề cần được xem xét.
Câu hỏi 2: Tại sao phải tạo RDV?
SMARTPLS không cung cấp trực tiếp một chức năng Full Collinearity VIF giống WarpPLS. RDV được sử dụng để tạo một biến nội sinh chung, qua đó các construct cần kiểm tra có thể cùng tham gia vào một phương trình dự báo.
Kazykhankyzy và cộng sự (2026) đã sử dụng cách thiết lập này khi tạo một RDV một chỉ báo và đưa tám latent variables vào vai trò exogenous constructs trên SMARTPLS.
Câu hỏi 3: Có cần Bootstrapping cho mô hình RDV không?
Không cần nếu mục tiêu chỉ là đánh giá Full Collinearity VIF. Kết quả cần lấy là VIF từ PLS-SEM Algorithm. Bootstrapping không cần thiết để xác định một VIF có vượt ngưỡng 3.3 hay không.
Câu hỏi 4: Có cần giữ RDV trong mô hình nghiên cứu chính?
Không cần. Tốt hơn nên tạo một model riêng để thực hiện Full Collinearity VIF. Sau khi hoàn thành bước kiểm tra CMB, mô hình nghiên cứu chính vẫn được sử dụng để tiếp tục đánh giá mô hình đo lường, mô hình cấu trúc và kiểm định các giả thuyết.
Câu hỏi 5: RDV có cần đánh giá độ tin cậy và AVE không?
Không. RDV trong cách triển khai này chỉ là biến kỹ thuật một chỉ báo, không phải một thang đo lý thuyết cần đánh giá Cronbach’s Alpha, Composite Reliability hay AVE như các construct của mô hình nghiên cứu.
7. Kết luận
Kiểm tra CMB bằng Full Collinearity VIF trong SMARTPLS có thể thực hiện bằng cách bổ sung một Random Dependent Variable (RDV) vào dữ liệu, đưa các biến tiềm ẩn cần đánh giá vào cùng dự báo RDV, sau đó chạy PLS-SEM Algorithm và lấy VIF tại cột RDV.
Khi áp dụng Full Collinearity Assessment của Kock (2015), VIF không vượt quá 3.3 được sử dụng làm tiêu chí để đánh giá. Phần cần chú ý nhất khi thực hành là lấy đúng VIF từ mô hình RDV, không nhầm với Inner VIF của mô hình nghiên cứu ban đầu và không diễn giải RDV như một biến phụ thuộc thực sự của đề tài.
Nếu bạn đang gặp khó khăn trong đánh giá CMB trên SMARTPLS hay phải xử lý dữ liệu vì có giá trị Full VIF vượt ngưỡng 3.3, bạn có thể tham khảo dịch vụ xử lý SMARTPLS của Xử Lý Định Lượng nhé.
Tài liệu tham khảo
Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1–10. DOI: 10.4018/IJEC.2015100101.
Kazykhankyzy, L., Khalmatova, Z., Seitova, M., Kılıç, E., & Çelik, H. E. (2026). An extended technology acceptance model to explain higher education students’ behavioral intention to use ChatGPT: The case of Kazakhstan. European Journal of Education, 61(3), e70746. DOI: 10.1111/ejed.70746.